ChatGPT-5のような大きなAIモデルは、どれだけのメモリを必要とするのでしょうか。ChatGPTが登場してからわずか3年で、AIの「胃袋」は大きく膨らんできました。その動きがメモリ株にどうつながるのかを整理します。
先に結論:GPT-5クラスを仮に10兆パラメータ(AIが学習で調整する数値の数)と置くと、パラメータを置くだけでFP16で約20TB、学習では数百TBのメモリが必要になる計算です。こうした大型化がHBM(AI向けの高帯域幅メモリ)の需要を押し上げ、メモリ3強の売上につながると見られています。パラメータ数は各社とも公表していないため、数字は推定にもとづく試算です。どこが推定かは、各表の下の注記に書いています。
※本ページはプロモーションを含みます。アフィリエイト広告を掲載しており、ご紹介するサービスが成約した際に当サイトに報酬が発生することがあります。
AIの「胃袋」はどこまで大きくなるのか
ChatGPTが登場してからわずか3年。その間に、AIモデルのサイズは速いペースで大きくなってきました。GPT-3は1,750億パラメータ、GPT-4は推定1.8兆です。すでに公開されているGPT-5のパラメータ数は公表されていませんが、業界では5兆〜10兆パラメータ規模という推定もあり、本記事ではこれを前提に試算します。
パラメータ数が増えることは、技術の数字だけの話ではありません。必要なメモリ(HBM)の量も増えるため、AI業界全体のHBM調達コストも大きく膨らみます。そのお金は、メモリ3強(SK Hynix・Samsung・Micron)の売上として積み上がっていきます。
LLMパラメータの急増|GPT-3からGPT-5まで
主要LLMのパラメータ数の推移を、表にまとめます。表の後半は公表値ではなく推定です。
| モデル | リリース年 | パラメータ数 | 前世代比 |
|---|---|---|---|
| GPT-2 | 2019年 | 15億(1.5B) | ― |
| GPT-3 | 2020年 | 1,750億(175B) | 約117倍 |
| GPT-4 | 2023年 | 推定1.8兆(1.8T) | 約10倍 |
| GPT-5(予測) | 2025〜2026年 | 推定5〜10兆 | 約3〜5倍 |
| GPT-6(超長期予測) | 2028年以降 | 数十兆以上 | ― |
※GPT-3・GPT-2以外のパラメータ数は公表されていない推定値です。モデル名・リリース時期・「予測」の表記は本記事の作成時点(2026年4月)のものです。
推定を含めて並べると、LLMのパラメータ数は2〜3年ごとに5〜10倍に増加してきたように見えます。Meta・Google・Anthropicなど他社のモデルも大型化が続いているとみられ、一時的な流行ではなく、AI産業全体の流れと考える見方が広がっています。
1パラメータあたりに必要なメモリ量は?
パラメータ数が、どれだけのメモリ量になるのかを見ていきます。
基本計算:FP16精度での必要メモリ
必要メモリ(パラメータ保存)
= パラメータ数 × 精度(バイト)
= 10兆パラメータ × 2バイト(FP16)
= 20TB
ただし、これは「パラメータを保存するだけ」の最小の容量です。実際の学習や推論では、さらに次のメモリが必要になります。
| 用途 | 追加メモリ(目安) | 用途説明 |
|---|---|---|
| 勾配(学習時) | パラメータと同容量 | バックプロパゲーション用 |
| オプティマイザ状態(Adam等) | パラメータの2〜3倍 | 学習履歴の保持 |
| アクティベーション | バッチサイズに比例 | 中間層の出力保持 |
| KVキャッシュ(推論時) | コンテキスト長に比例 | 長文処理の高速化 |
実際の学習に必要なメモリ総量
10兆パラメータモデルの学習に必要なメモリ
= パラメータ(20TB) + 勾配(20TB) + オプティマイザ(60TB) + アクティベーション
≒ 数百TB(合計)
「数百TB」という量は、1基のGPUにはとても収まりません。そこで、数万台のGPUを同時に動かし、それぞれに数十〜数百GBのHBMを持たせて、学習を分担させる構成が必要になります。
GPT-5の学習クラスタに必要なHBM総量を試算
ここでは、GPT-5クラスの10兆パラメータモデルを仮に置き、学習に必要なGPU数・HBM総量を試算します。
| 項目 | 数値 |
|---|---|
| モデル規模 | 10兆パラメータ |
| 使用GPU | NVIDIA B200(HBM 192GB/台) |
| 必要GPU数(推定) | 約3万〜10万台 |
| 1クラスタのHBM総量 | 約5,760TB〜19,200TB |
| HBM調達額(1クラスタあたり) | 約5〜16億ドル |
| 学習期間 | 数ヶ月〜1年 |
この試算は1クラスタ分です。OpenAIだけでなく、Meta(Llama 4・5)、Google(Gemini 2・Ultra)、Anthropic(Claude 5)、xAI(Grok 4)なども、大きなモデルの開発を並行して進めています。仮にどこも同じような規模で学習すると、業界全体で毎年数十億ドル規模のHBMが消費されている計算になります。
AI巨大化の恩恵を受けるMicron株をDMM株で購入
米国の唯一のHBMメーカーMicron(MU)は、AIモデル巨大化の直接的な受益者です。DMM株はNISA口座なら米国株の取引手数料0円(課税口座は約定代金×0.495%・上限22ドル)で、最短即日の口座開設が可能です。
※広告・PR
Llama 4 / Gemini 2 / Claude 5でも同じ構造
GPT-5だけでなく、競合他社のLLMも大型化が進んでいます。各社ともパラメータ数を公表していないものが多く、下の表の数字は推定です。
| モデル | 開発元 | 推定パラメータ数 | リリース時期 |
|---|---|---|---|
| GPT-5 | OpenAI | 5〜10兆 | 2025〜2026年 |
| Claude 5 | Anthropic | 5〜10兆級 | 2026年 |
| Gemini 2 Ultra | Google DeepMind | 5〜10兆級 | 2026年 |
| Llama 4 | Meta | 2〜5兆 | 2025〜2026年 |
| Grok 4 | xAI | 2〜5兆 | 2026年 |
| 中国系(Qwen・DeepSeek等) | 中国Big Tech | 1〜5兆 | 2025〜2026年 |
※推定パラメータ数は各社が公表していない推定値です。モデル名とリリース時期は本記事の作成時点(2026年4月)のもので、その後に出たモデルは含みません。
GPT-5だけで話は終わりません。推定どおりなら、世界中のAI企業が同時並行で数兆パラメータ級モデルを開発していることになります。それぞれが数万GPUのクラスタを必要とし、数億ドル規模のHBMを使う計算です。
推論(インフェレンス)でも、メモリは足りなくなるのか
AIのメモリ需要は「学習」だけではありません。見落とされやすいのが、推論(インフェレンス)におけるメモリ消費です。推論とは、学習を終えたAIが実際に質問へ答える処理のことです。
推論時のメモリ使用量
推論のときも、モデルのパラメータ全体をGPUメモリに置いておく必要があります。10兆パラメータモデルなら、FP16で約20TB、量子化して8bit/4bitに縮めても数TBのHBMが必要です。
KVキャッシュも大きく膨らみます
ChatGPTで長い対話や長い文書の分析をすると、読み込む文章の長さに比例して、KVキャッシュと呼ばれる途中のデータが大きくなります。最新モデルでは100万トークン以上のコンテキストに対応しており、これだけで1推論あたり数GBのメモリを追加で使います。
推論需要は学習の10倍以上になる可能性
モデルの開発は基本的に1社のAI企業が行いますが、推論は数億人のユーザーがアクセスするたびに発生します。ChatGPTだけでも週次アクティブユーザーは数億人、1日の推論回数は数十億回規模です。
業界では、「今後5年でAI用HBM需要の7〜8割は推論用途が占める」という見方も出ています(本記事では出典を確認できていない推定として紹介します)。この見方どおりなら、学習用の何倍もの規模で、推論用のHBM需要が生まれることになります。
マルチモーダルAIは、さらにメモリを使います
最近のAIは、テキストだけでなく画像・音声・動画もまとめて扱う「マルチモーダル」が広がっています。扱うデータが増える分、メモリの消費もさらに大きくなります。
| モダリティ | 1リクエストあたりトークン数 | メモリ消費の特徴 |
|---|---|---|
| テキストのみ | 数千〜数万 | 比較的軽量 |
| 画像(1枚) | 約1,000〜3,000トークン相当 | 高解像度ほど増加 |
| 音声(1分) | 約3,000〜5,000トークン相当 | 長時間でリニア増加 |
| 動画(1分) | 数万〜数十万トークン相当 | メモリ消費が爆発的 |
動画生成AI(OpenAI Sora、Google Veo、Runwayなど)は、画像生成AIの数十倍のメモリを使うとされます。動画生成が広がれば、HBMの需要はさらに上振れする可能性があります。
メモリ生産能力は追いつくのか?
ここまで、AIの側ではHBMの消費が急速に増えていく見通しを見てきました。では、作る側(メモリ3強)の生産能力は、これに追いつけるのでしょうか。
| メーカー | HBMの生産能力(報道・推定) | 出どころ |
|---|---|---|
| SK Hynix | 月15万〜20万枚程度(ウエハ) | 業界の推定(韓国ETNews・2026年9月の報道) |
| Samsung | 月15万〜20万枚程度(ウエハ)。別の報道では、HBM向けにDRAMウエハを月約15万枚投入し、うち約7.5万枚がHBM4向け | 業界の推定(同)/朝鮮日報の報道 |
| Micron | 2025年は月4万〜5万枚 → 2026年末に月約10万枚の見込み | ETNewsの推定と関係者の話(会社は公表していません) |
※出典:TrendForce(2026年9月4日)が紹介した、韓国のETNews・朝鮮日報の報道の数字です。各社とも生産能力を公式には公表していないため、報道によって数字に幅があります。以前の表にあった2025〜2027年の数字は出典を確認できなかったため、2026年10月1日にこの表へ差し替えました。
各社とも生産能力を大きく広げていますが、それでもHBM需要の伸びに追いつかないと見られています。特にHBM4以降は、16層スタックの歩留まり(良品になる割合)が壁になり、実際に作れる量はさらに絞られる可能性があります。
作る側の会社も、品薄が続くと見ています。Micronは2026年9月30日の決算説明会で、2027年と2028年のメモリの需給は2026年よりはるかに引き締まり、需給がいつ釣り合うかは見通せないと述べました。2027年度の設備投資は従来の計画より増やし、上半期だけで約250億ドル、下半期はさらに増える見込みです。増やす分の多くは工場の建屋(クリーンルーム)の建設で、2028年後半以降に使える場所を早く用意するためとしています(Micron 説明会の原稿)。
こうした見方からは、2026〜2028年もHBMの慢性的な供給不足が続くと考えられています。供給が足りない状態は、メーカーが価格を決める力を強め、利益率を高く保つ要因になります。
メモリ株との関わり方|3つのアプローチ
AIモデルの大型化を背景にメモリ株を考える場合、次の3つのアプローチがあります。
アプローチ1:個別銘柄で「当たり」を狙う
SK Hynix、Micron、Samsungの3強に個別に投資する方法です。HBMで先行しているSK Hynixや、米国企業のMicronなどが選択肢になります。
アプローチ2:装置メーカーで幅広く恩恵を取りに行く
HBMの製造に必要な装置を供給する東京エレクトロン・アドバンテスト・ディスコは、どのメモリメーカーが伸びても恩恵を受けやすい立場です。特定のメーカーに偏らない点で、リスクを分散しやすくなります。
アプローチ3:ETFで「分散」する
半導体ETF(SOXX、SMH)や、国内上場の半導体ETF(2243など)に投資する方法です。メモリだけに絞ることはできませんが、AI半導体全体の流れにまとめて投資できます。
日本の半導体装置株を買うなら松井証券
東京エレクトロン(8035)、アドバンテスト(6857)、ディスコ(6146)などの日本半導体装置株は、どのメモリメーカーが勝っても恩恵を受ける「ピッケルとシャベル」銘柄です。松井証券なら1日50万円まで取引手数料無料です。

※広告・PR
初心者におすすめの買い方
メモリ株に投資してみたいけれど、個別株は不安。そんな方は、次のような順番で考えると整理しやすくなります。
- Step1:DMM株で口座開設(無料・最短即日)
- Step2:Micron(MU)を1株から購入してみる(金額は株価で大きく変わるため、最新の株価を確認)
- Step3:慣れてきたら松井証券で日本の半導体装置株も追加
- Step4:さらに余裕があれば韓国メモリ株(SK Hynix・Samsung)も検討
米国メモリ株(Micron)を1株から始める
DMM株はNISA口座なら米国株の取引手数料0円(課税口座は約定代金×0.495%・上限22ドル)。Micron(MU)は1株単位で購入できます(1株の金額は株価で大きく変わるため、最新の株価を確認してください)。
※広告・PR
▼ 投資アプリでサクッと始めるならTOSSY

※広告・PR かんたんステップでアカウント登録
Q&A
Q. ChatGPT-5のパラメータ数はどのくらいですか?
A. OpenAIは公式にパラメータ数を公開していませんが、業界推定ではGPT-5は約5〜10兆パラメータと見られています。GPT-3の175B、GPT-4の推定1.8Tと比較して、1世代で約5倍のスケールです。
Q. 1パラメータに必要なメモリはどのくらいですか?
A. FP16精度で1パラメータあたり2バイト、推論時のKVキャッシュなどを含めると実効的に4〜8バイト必要です。10兆パラメータのモデルなら、学習時に数百TBのメモリ、推論時でも数十TBのHBMが必要です。
Q. GPT-5の学習にはGPUが何台必要ですか?
A. 業界推定では、GPT-5クラスのモデル学習には数万〜10万台規模のNVIDIA H100/H200/B200 GPUが必要です。1クラスタあたり数TB〜数十TBのHBMが消費され、学習完了まで数ヶ月稼働します。
Q. 推論(インフェレンス)でもメモリは不足しますか?
A. はい。推論時も全モデルパラメータをGPUメモリに常駐させる必要があり、マルチターン対話や長文コンテキストではKVキャッシュが肥大化します。結果として、推論向けGPUクラスタも学習と同様にHBMを大量消費します。
Q. AIモデル巨大化はメモリ株にどう影響しますか?
A. AIモデルのパラメータは指数的に増加しており、1世代ごとに必要HBM量が数倍になります。これはメモリ3強(SK Hynix・Samsung・Micron)の売上を構造的に押し上げる要因であり、メモリ株の長期成長ドライバーです。
まとめ
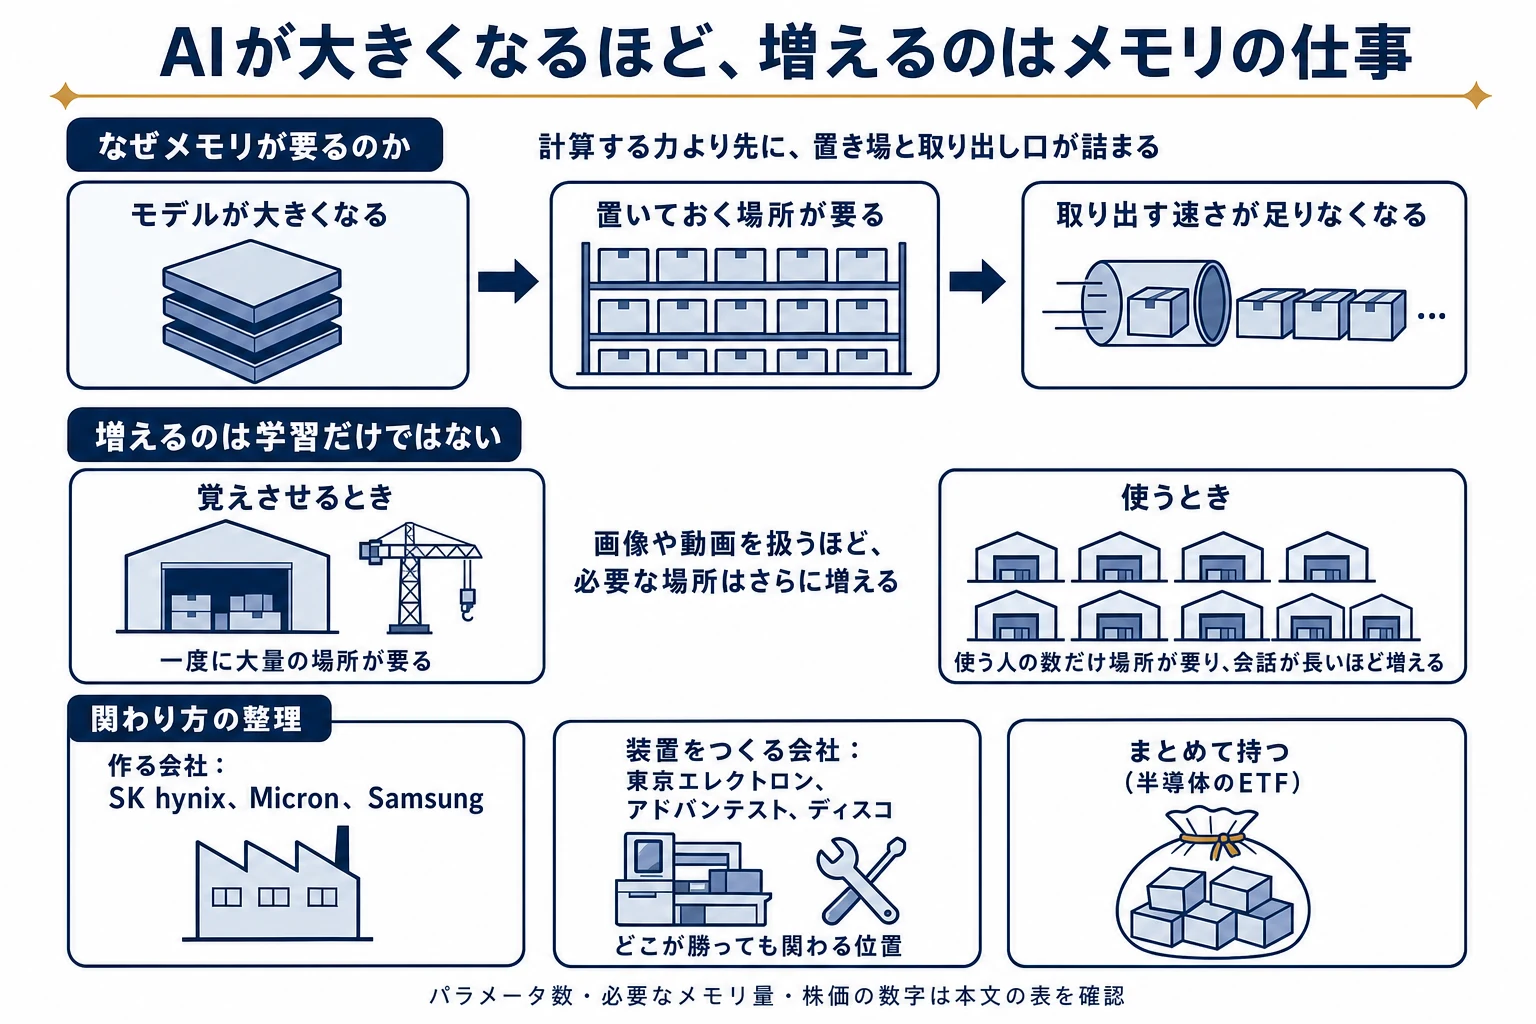
AIモデルの大型化は、メモリ株にとって「需要側からの構造的な追い風」と見られています。GPT-5、Claude 5、Gemini 2、Llama 4など、主要なLLMは推定で数兆パラメータ級へと進んでおり、それぞれが数億ドル規模のHBMを使う計算です。
- LLMパラメータは2〜3年で5〜10倍に増加してきたとみられる
- 10兆パラメータモデルの学習に必要なHBMは数百TB
- 推論市場は学習の10倍以上に拡大する可能性があるとの見方も
- マルチモーダル・動画生成AIでメモリ消費はさらに増大
- 供給側の生産能力は需要の伸びに追いつかず、価格は高水準で推移するとの見方
この需要増の恩恵を最も直接受けやすいのが、メモリ3強とその装置メーカーです。DMM株と松井証券の口座があれば、米国のメモリ株と日本の装置株の両方を売買できるようになります。
本記事の試算のうち、どれが公表値でどれが推定なのかを、表の注記と照らし合わせておくのも一つの手です。
▼ どちらの口座もNISAなら手数料無料・最短即日開設
米国株(Micron/NVDA/ETF)なら
日本株(東京エレクトロン/アドバンテスト)なら

※広告・PR
※本記事は情報提供を目的としており、投資の勧誘を目的とするものではありません。投資にはリスクが伴います。投資判断はご自身の責任で行ってください。
※GPT-5のパラメータ数、必要GPU数、HBM総量の試算は業界アナリスト推定に基づく概算です。実際の数値はOpenAI等の各社公式発表により異なる場合があります。